Modelos de visão: LLMs com entrada de imagens
Compare LLMs multimodais que aceitam imagens e texto como entrada usando o Artificial Analysis Visual Reasoning Index. Compare o desempenho, os preços e a latência entre os provedores para escolher o melhor LLM com entrada de imagens para cargas de trabalho de visão. Para mais detalhes, consulte a página de metodologia.
Destaques
Resumo da análise
Raciocínio visual vs. preço da entrada de imagens
Visual reasoning intelligence: MMMU Pro evaluation · Image input price: USD per 1k images at 1MP (1024x1024)
Most attractive quadrant
Raciocínio visual vs. latência (entrada de uma imagem e 1.000 tokens de linguagem)
Visual reasoning intelligence: MMMU Pro evaluation · Seconds to first token received
Most attractive quadrant
Inteligência
Inteligência de raciocínio visual (avaliação MMMU Pro)
Visual reasoning intelligence: MMMU Pro evaluation
Preços
Pricing: Image Input Pricing
Image input price: USD per 1k images at 1MP (1024x1024)
Preços: entrada de linguagem, entrada de imagens e saída de linguagem
Price (USD per M Tokens) · Image input price: USD per 1k images at 1MP (1024x1024) · Lower is better
Latência e velocidade
Latência (entrada de uma imagem e 1.000 tokens de linguagem)
Seconds to first token received · Lower is better
Variação da latência (entrada de uma imagem e 1.000 tokens de linguagem)
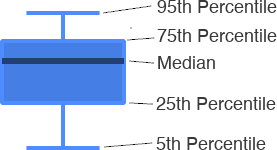
Seconds to first token received · Results by percentile · Lower is better
Velocidade de saída (entrada de uma imagem e 1.000 tokens de linguagem)
Output tokens per second · Higher is better