面向政府的
基准测试
Artificial Analysis 是领先的独立基准测试公司,覆盖 AI 智能体、模型、推理与硬件。我们衡量风险、安全、网络安全、能力、成本与性能,帮助公共部门做出 AI 决策。
我们如何支持政府
Artificial Analysis 提供基准测试、咨询与数据,帮助公共部门客户制定 AI 政策并选择 AI 技术。
制定 AI 政策,支持决策
AI 的进展对政府、行政机关和公共部门具有关键的政策与监管含义:
- 哪些模型是安全的?我们如何保护关键系统与基础设施?
- AI 从事的知识工作会对就业和经济产生什么影响?
- 政府如何在创新、竞争、国家安全与数据中心建设等国家优先事项之间取得平衡?
作为领先的独立基准测试公司,我们以深厚的专业能力来回应这些紧迫问题。
选择 AI 技术
AI 能力与成本都在快速提升。我们支持公共部门理解、衡量并选择 AI 技术:
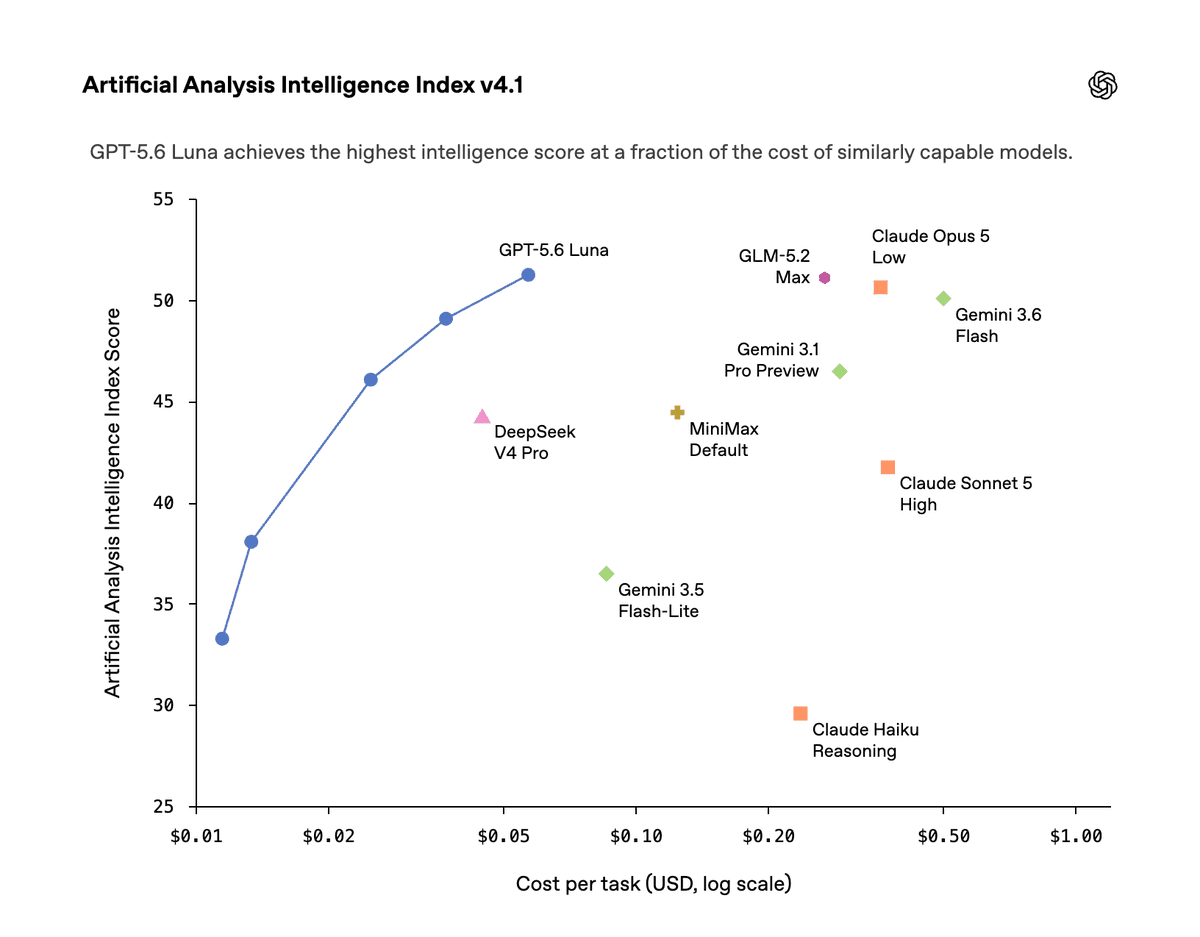
- 如何以最低成本负责任地部署最强的模型?
- 如何用高效的智能体赋能工作人员?
- 未来一年,AI 将解决哪些公共部门用例?
我们的基准测试服务、数据与专业能力可以帮助公共部门客户以最低成本安全地最大化 AI 性能。
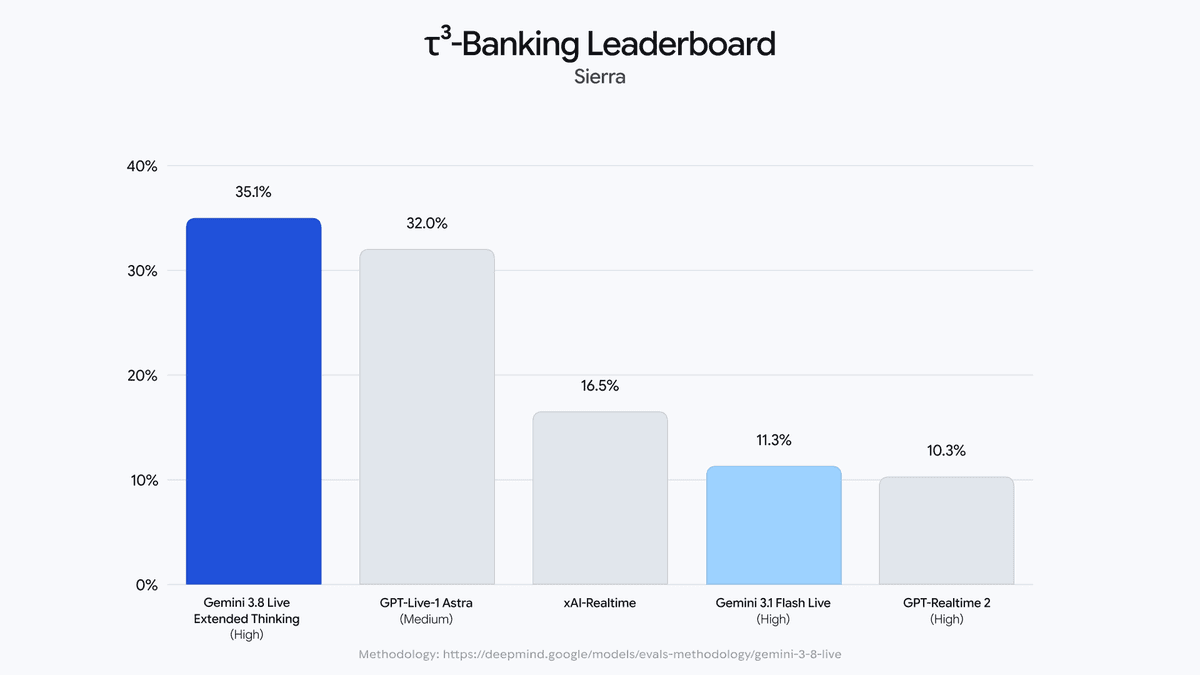
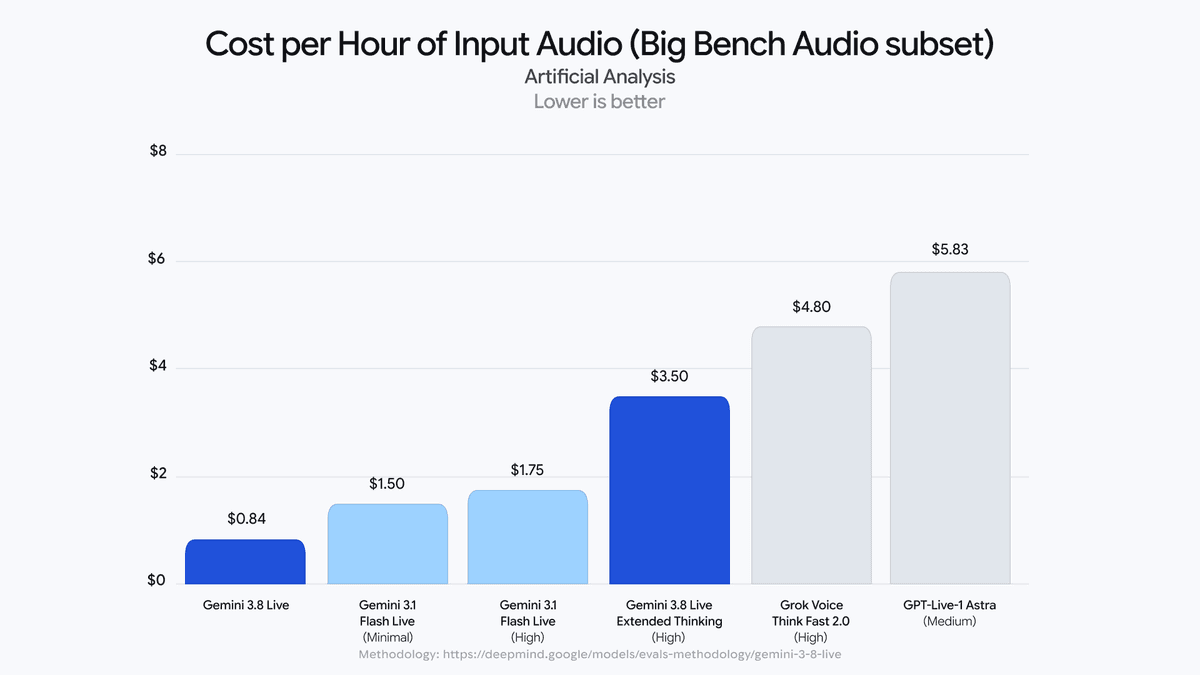
被领先的 AI 实验室、媒体与机构公开引用


我们的专题专长
网络安全与 AI 安全
我们可以支持联邦、州和地方各级政府以及行业客户,从以下方面审计模型:
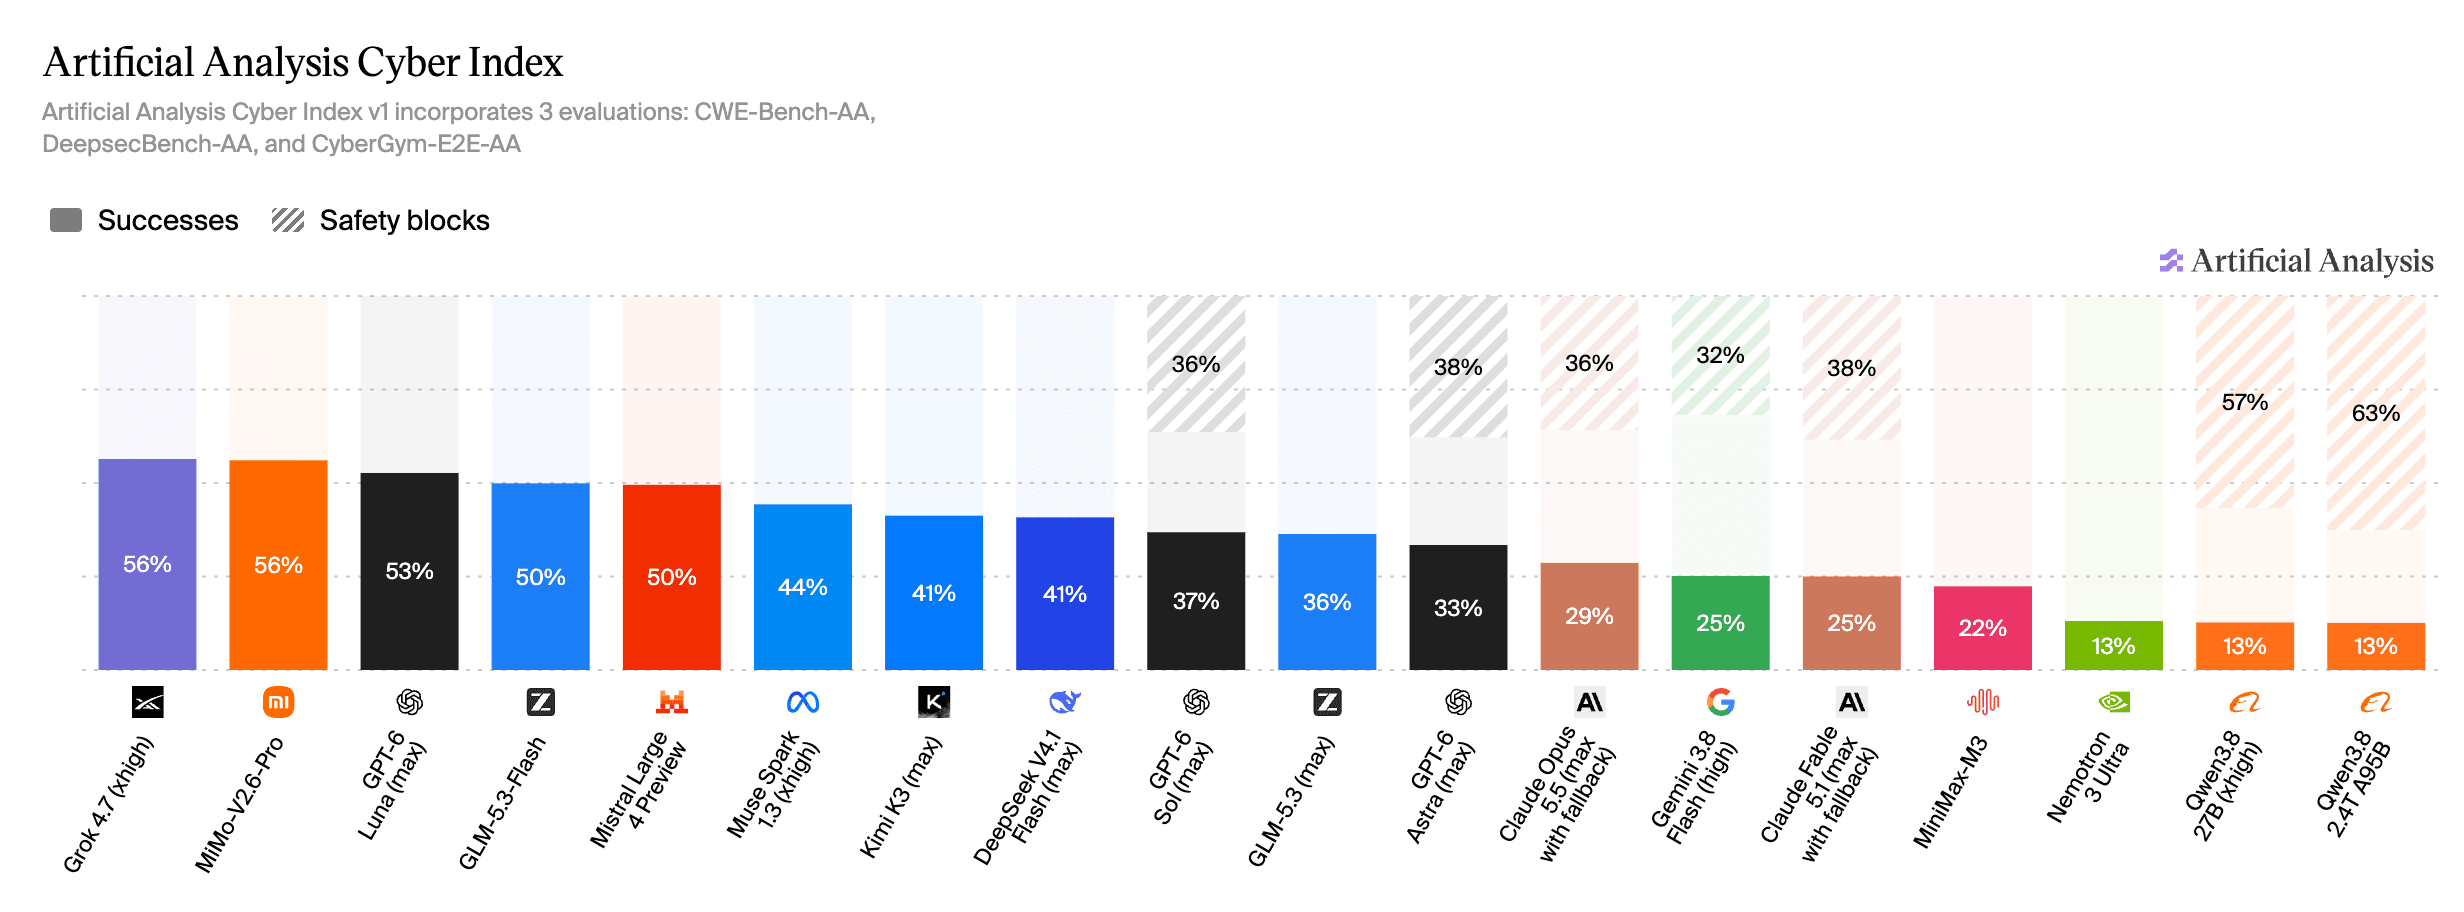
- 网络安全:我们使用网络安全基准测试,衡量模型在白盒、灰盒与黑盒攻击面上的防御性网络安全能力,包括漏洞识别、修复与事件响应。
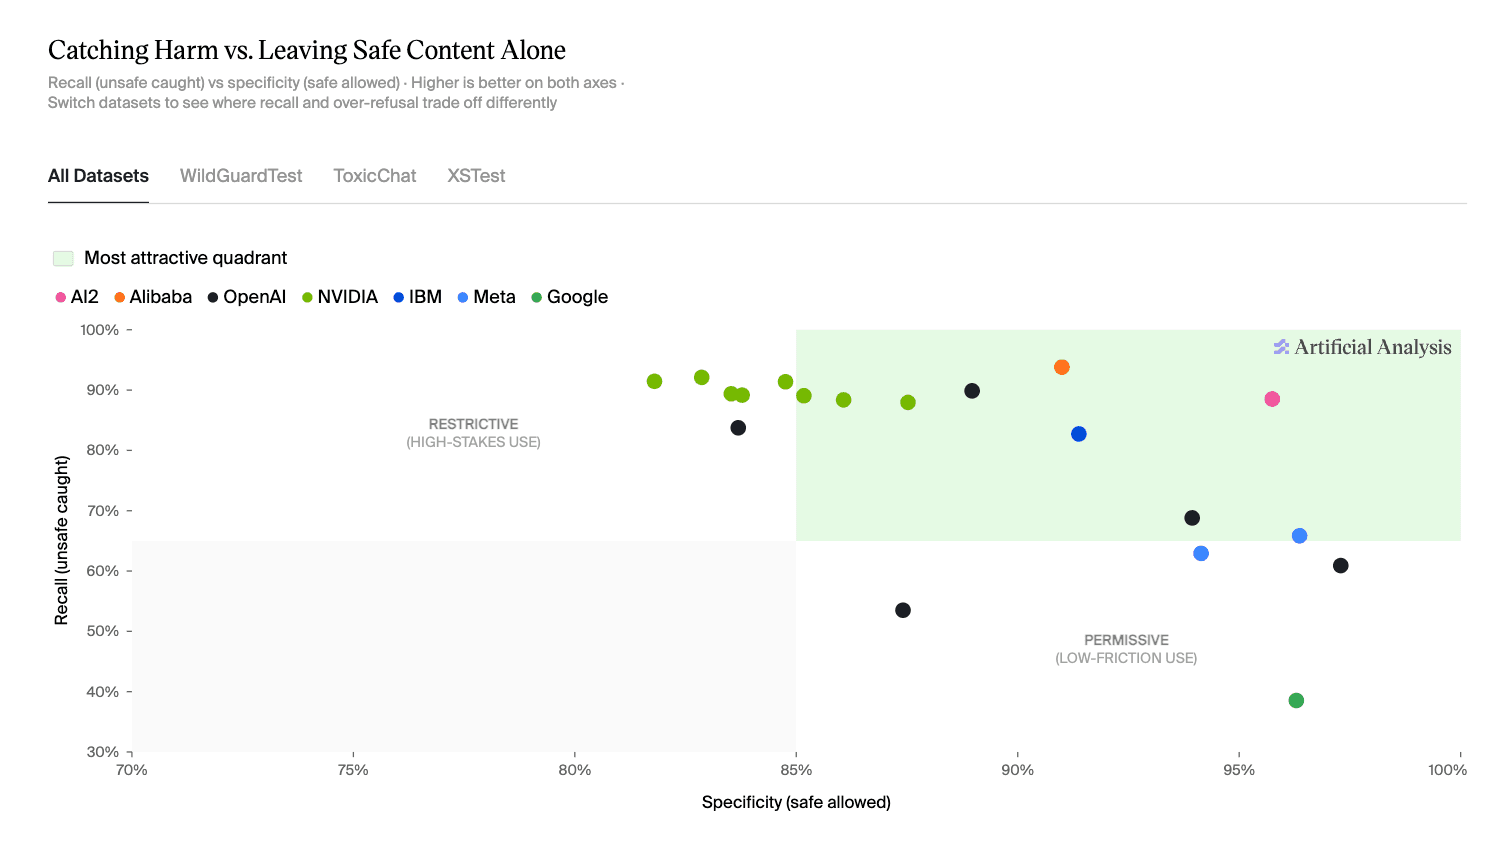
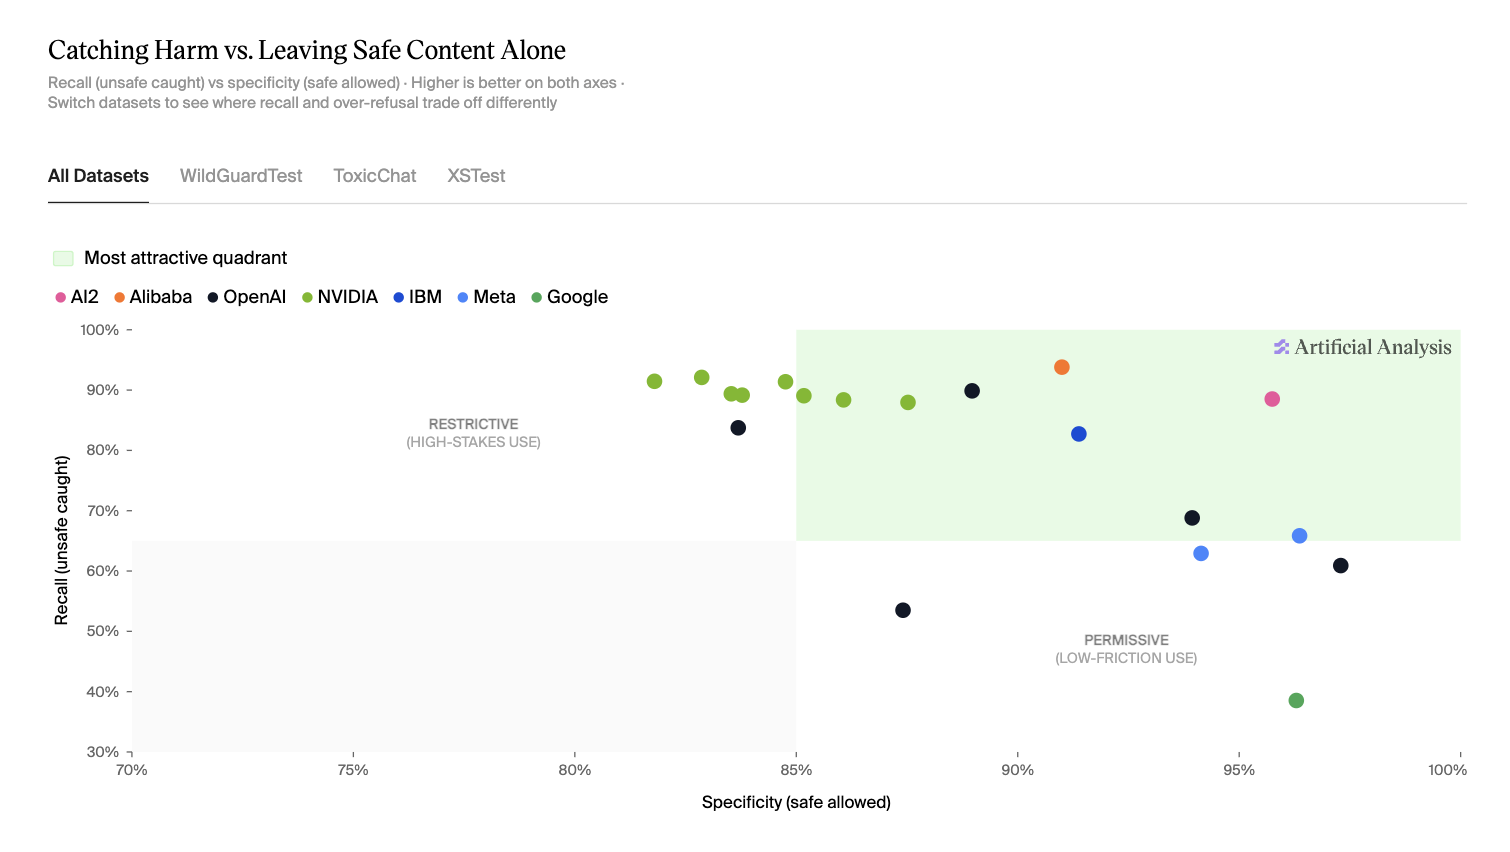
- AI 安全:我们在广泛的伤害类型(例如 CBRNE、暴力、隐私)以及逐步升级的对抗压力下评估模型,从直接请求到复杂的诱导手段,以同时衡量能力与可信度。
案例研究
Artificial Analysis Cyber Index Alliance
The Artificial Analysis Cyber Index Alliance brings together industry partners to set a new standard for evaluating how AI models perform on enterprise cyber defense tasks. The Alliance launches alongside the Artificial Analysis Cyber Index, which combines three partner-contributed and open benchmarks to evaluate how well agents find and fix vulnerabilities.
 NVIDIA
 IBM
 Vercel
 Collinear AI
智能
能力、成本与性能
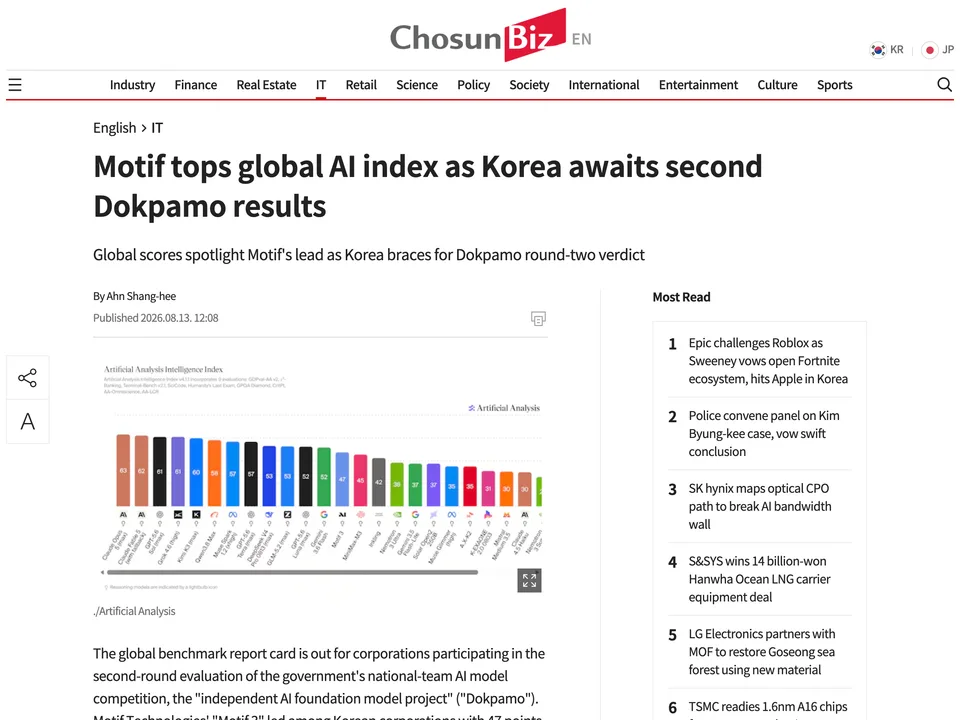
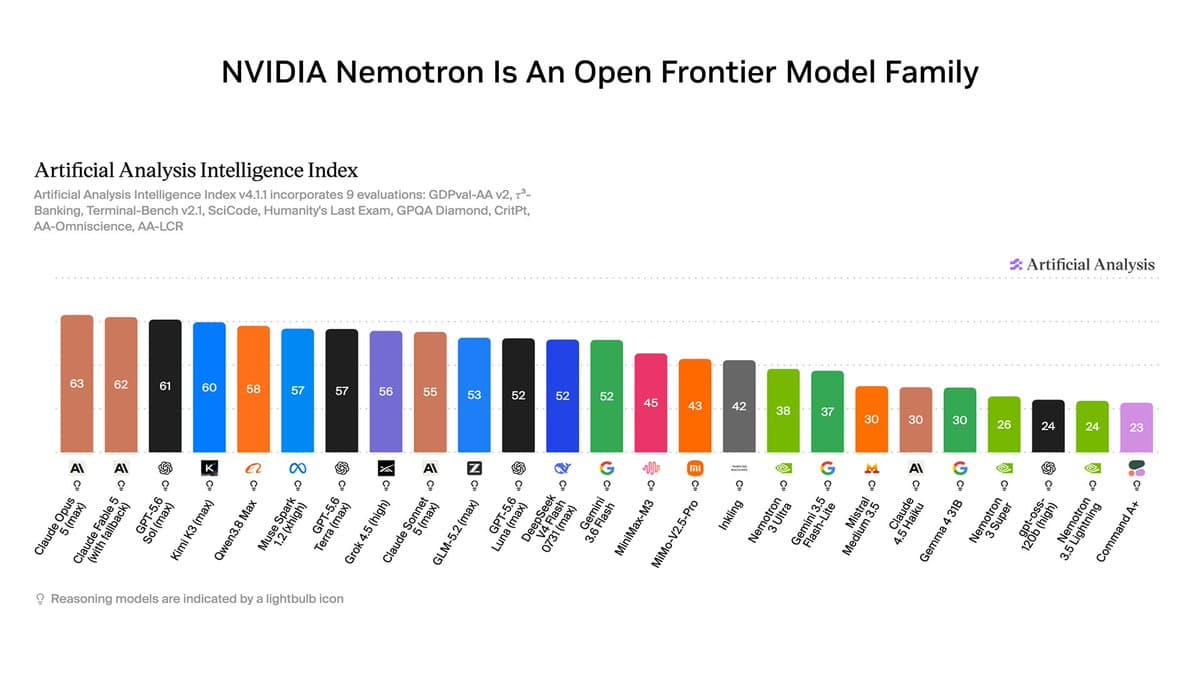
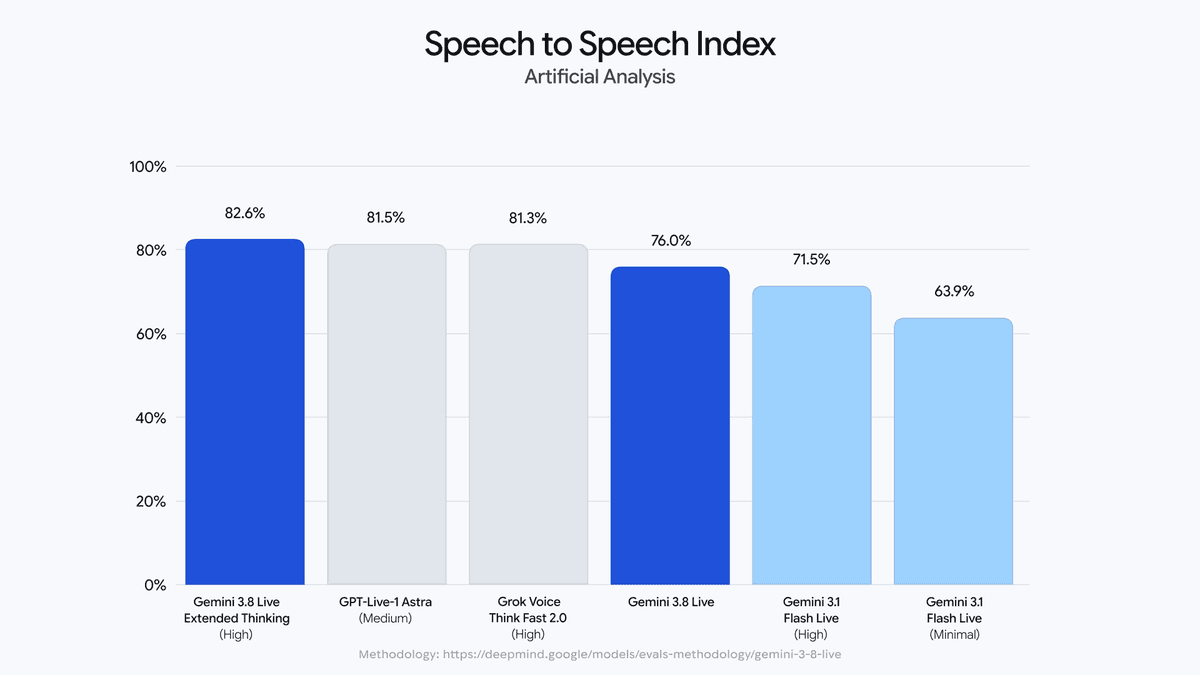
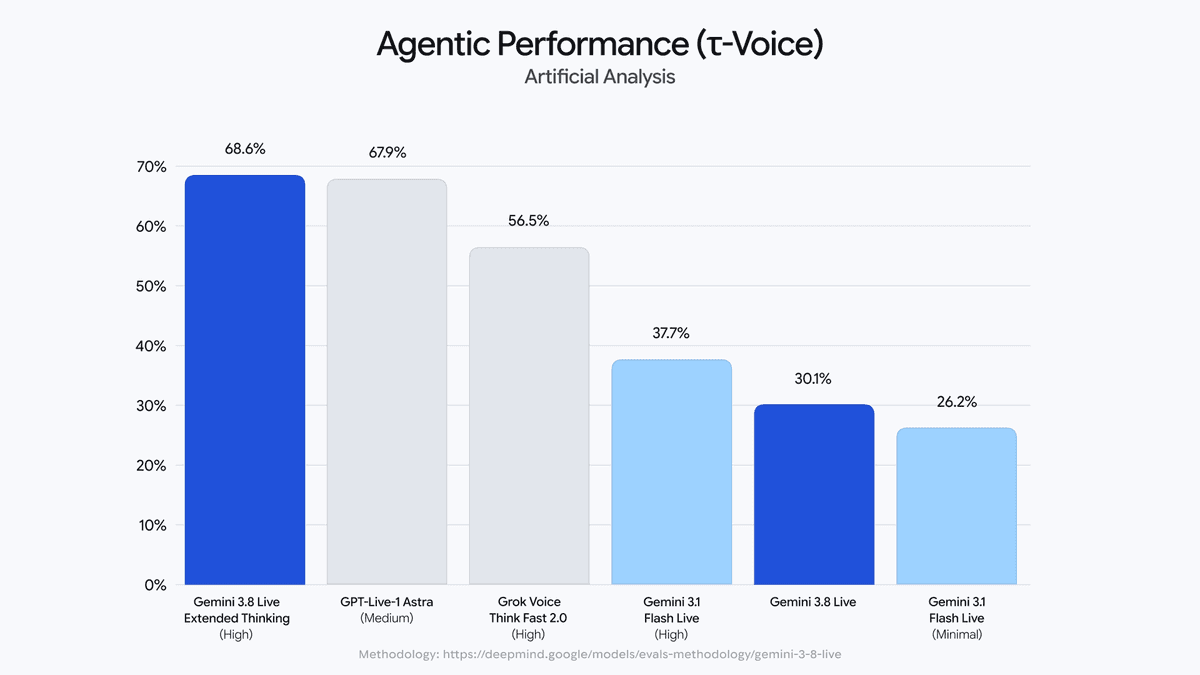
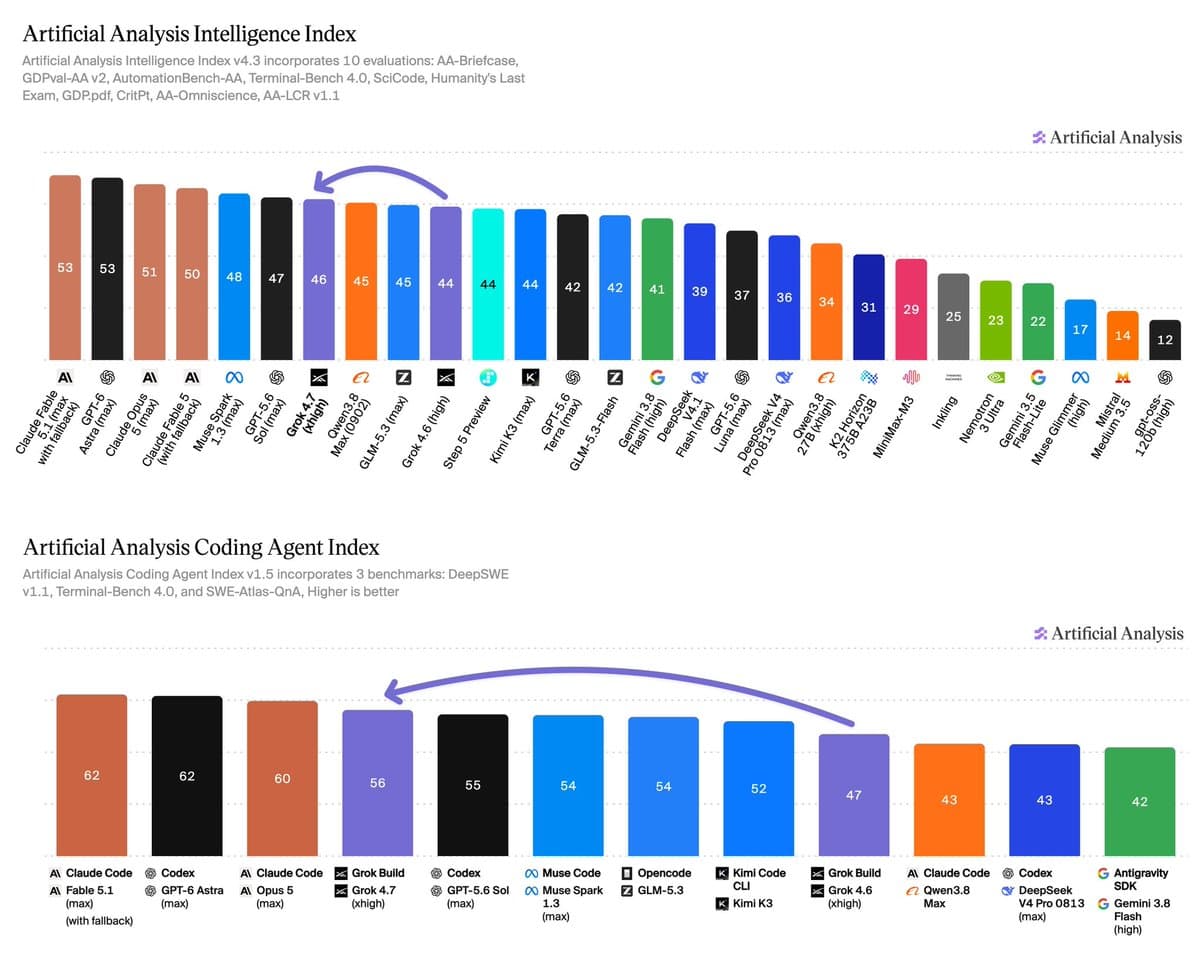
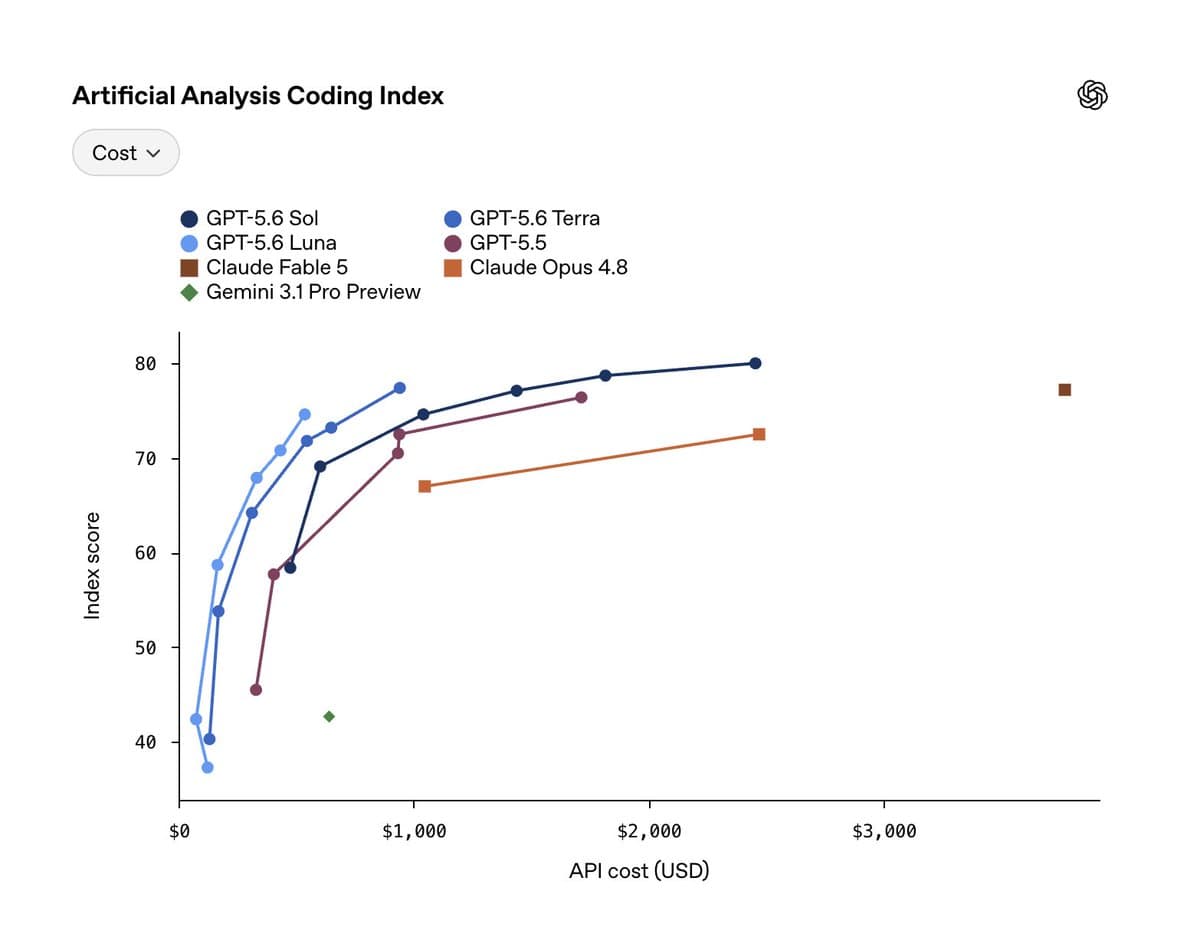
Artificial Analysis 定义了衡量模型与智能体的能力、准确性、幻觉、成本、速度与延迟的全球标准。我们在前沿模型发布中被广泛引用,例如 Claude Opus 5.5 和 GPT-5.6。
对于公共部门,我们独立呈现模型能完成哪些任务、需要多少成本以及耗时多久。这对于指导政策设计问题(例如 AI 将如何影响就业)和技术选型(例如为某个用例选择哪个模型)至关重要。
案例研究
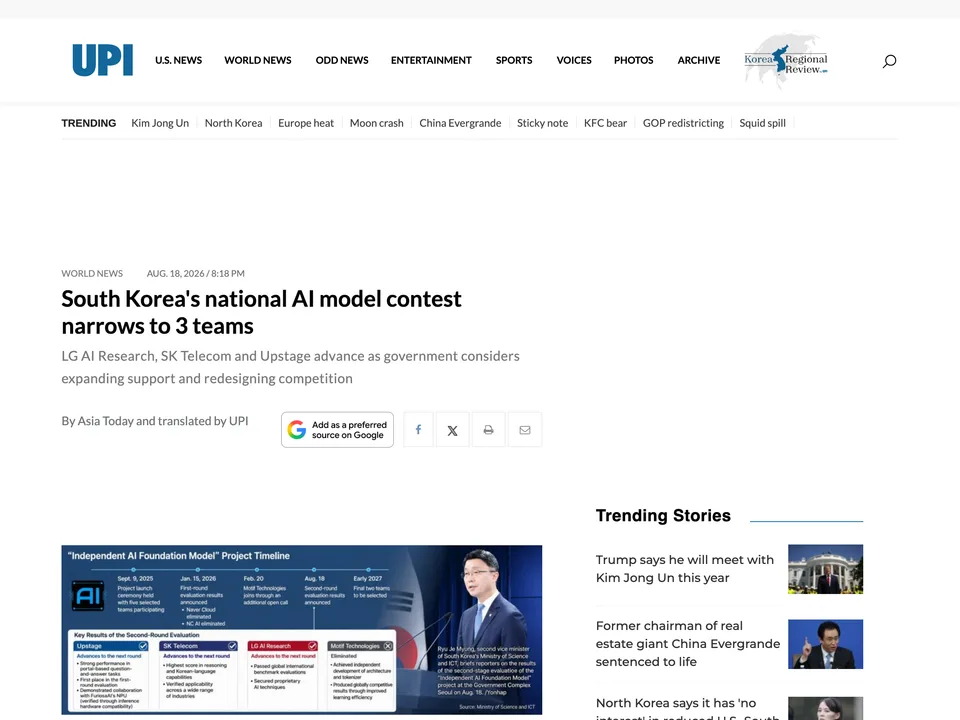
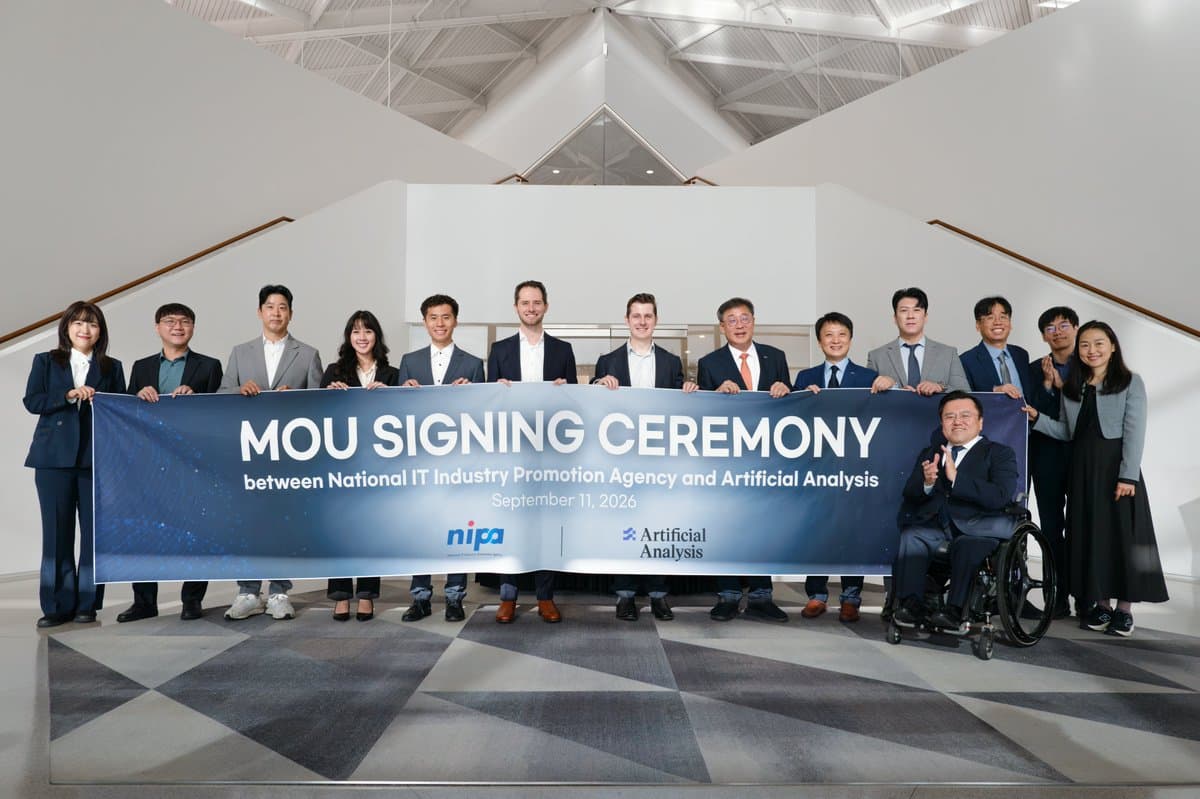
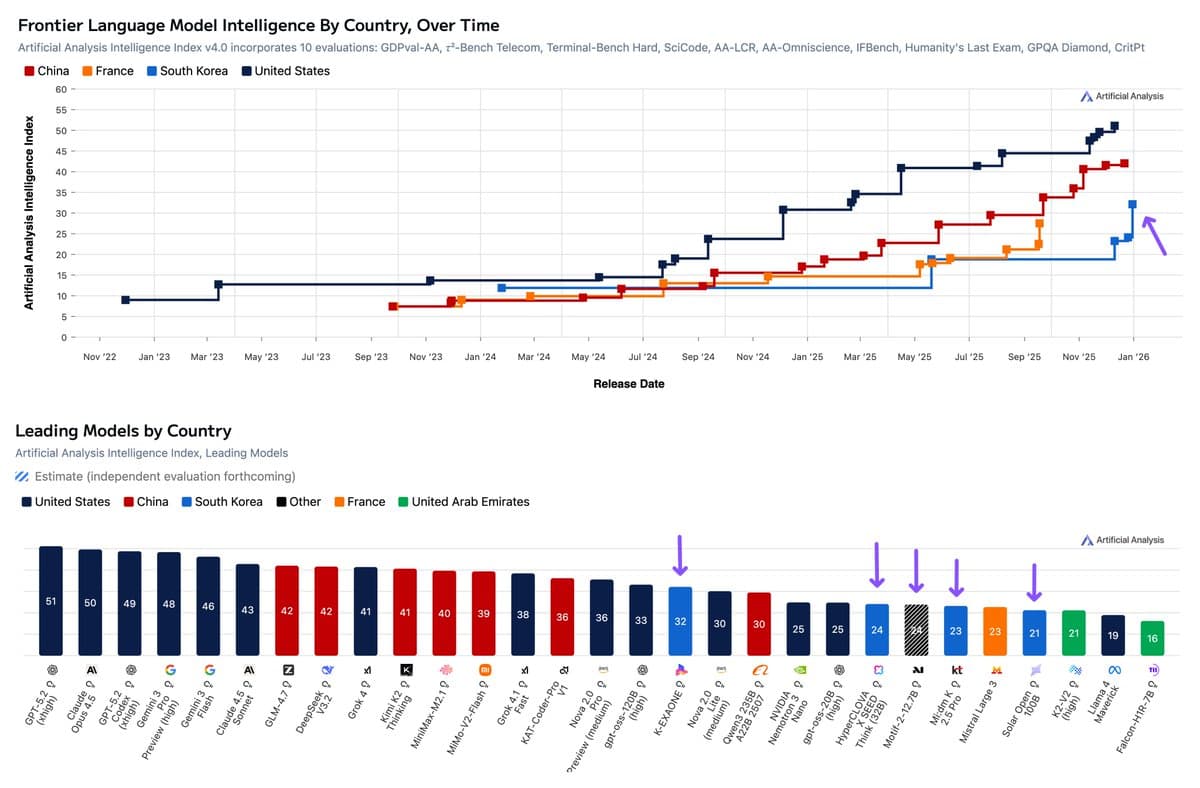
韩国政府的基准测试合作伙伴
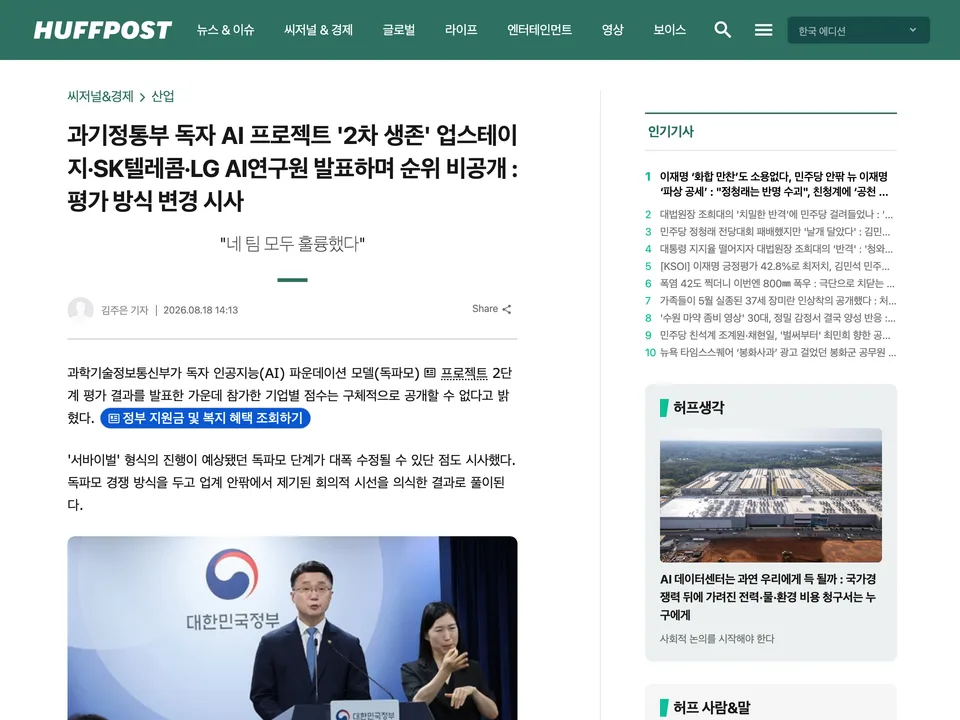
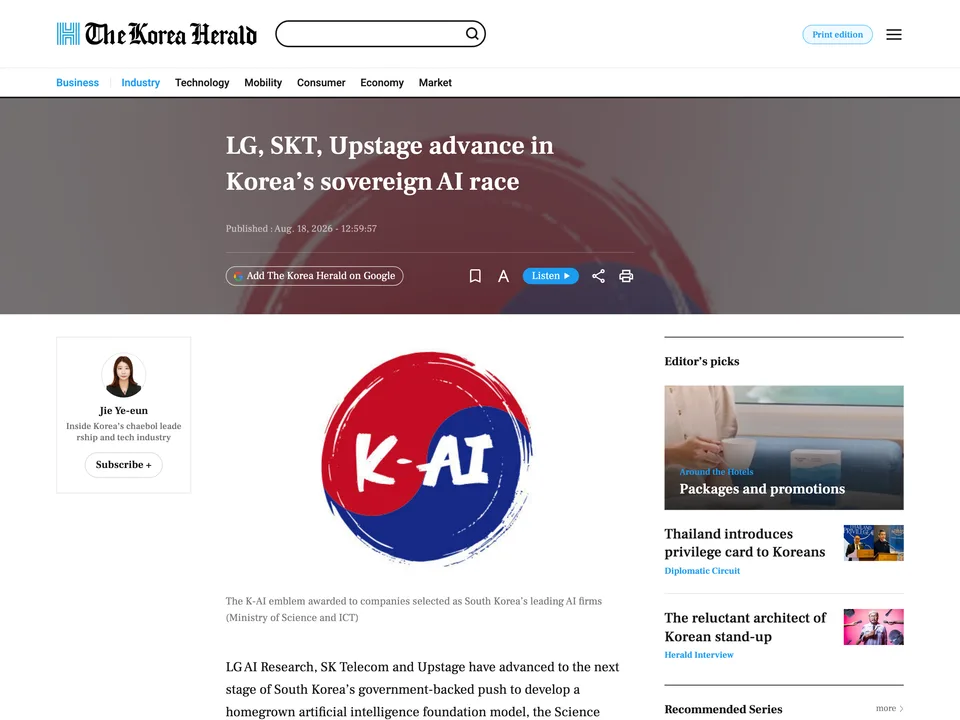
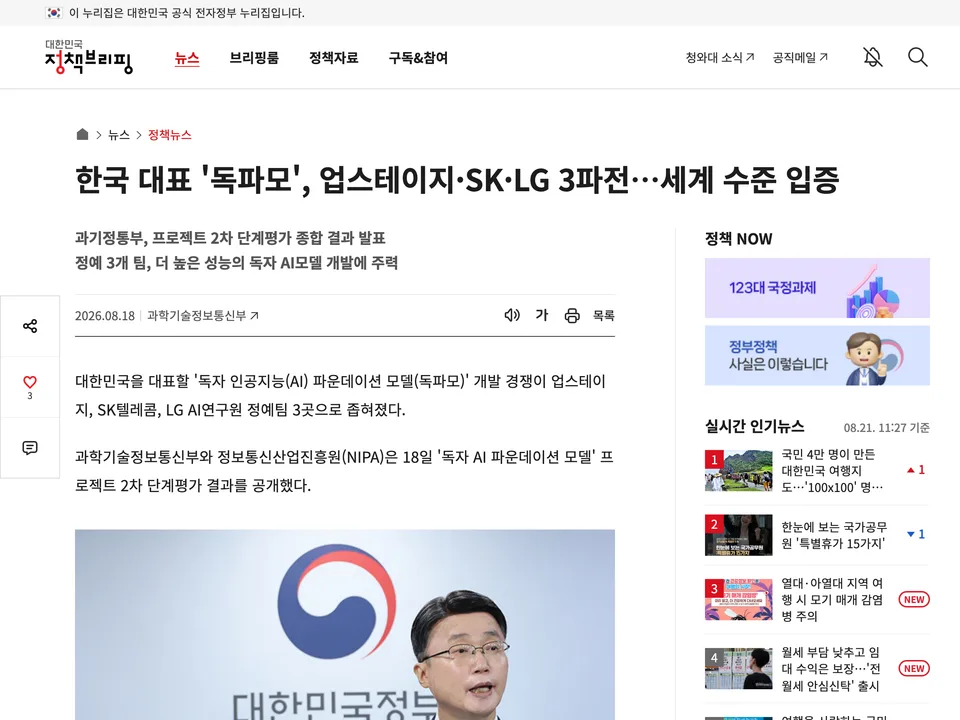
我们是韩国主权 AI 基础模型项目的基准测试合作伙伴,该项目由科学技术信息通信部(MSIT)和 NIPA 主导。我们支持了评估方法论设计、评估运行与结果报告。
网络安全
Artificial Analysis Cyber Index Alliance
Artificial Analysis Cyber Index Alliance 汇聚行业合作伙伴,为评估 AI 模型在企业网络防御中的表现树立新标准。
该联盟与 Artificial Analysis Cyber Index 同步启动。该指数衡量模型的防御性网络能力:发现代码库中的漏洞,复现并验证这些漏洞,以及在不破坏现有功能的前提下修补漏洞。
Cyber Index v1 整合了三项网络安全评测:CWE-Bench-AA、DeepsecBench-AA 和 CyberGym-E2E-AA。

业界首选参考











联系我们
Artificial Analysis 可以通过基准测试、咨询与数据,支持联邦、州和地方各级政府制定 AI 政策并选择 AI 技术。