Vision-Modelle: LLMs mit Bildeingabe
Vergleichen Sie multimodale LLMs, die Bild- und Texteingaben unterstützen, mit dem Artificial Analysis Visual Reasoning Index. Vergleichen Sie Leistung, Preise und Latenz verschiedener Anbieter, um das beste bildfähige LLM für visuelle Workloads auszuwählen. Weitere Details finden Sie auf der Methodikseite.
Wichtigste Ergebnisse
Zusammenfassende Analyse
Visuelles Schlussfolgern vs. Preis der Bildeingabe
Visual reasoning intelligence: MMMU Pro evaluation · Image input price: USD per 1k images at 1MP (1024x1024)
Most attractive quadrant
Visuelles Schlussfolgern vs. Latenz (Eingabe: ein Bild und 1.000 Texttokens)
Visual reasoning intelligence: MMMU Pro evaluation · Seconds to first token received
Most attractive quadrant
Intelligenz
Intelligenz beim visuellen Schlussfolgern (Evaluation MMMU Pro)
Visual reasoning intelligence: MMMU Pro evaluation
Preise
Pricing: Image Input Pricing
Image input price: USD per 1k images at 1MP (1024x1024)
Preise: Texteingabe, Bildeingabe und Textausgabe
Price (USD per M Tokens) · Image input price: USD per 1k images at 1MP (1024x1024) · Lower is better
Latenz und Geschwindigkeit
Latenz (Eingabe: ein Bild und 1.000 Texttokens)
Seconds to first token received · Lower is better
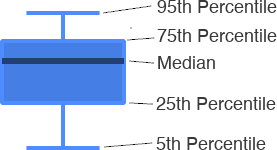
Latenzvarianz (Eingabe: ein Bild und 1.000 Texttokens)
Seconds to first token received · Results by percentile · Lower is better
Ausgabegeschwindigkeit (Eingabe: ein Bild und 1.000 Texttokens)
Output tokens per second · Higher is better